La plateforme
Une fondation de données que vos équipes gardent en main.
beVault s'appuie sur le Data Vault comme fondation, puis automatise ce qui coûte le plus cher : produire et maintenir le code de chargement, contrôler la qualité, orchestrer les traitements et publier des données prêtes à l'usage — dans l'environnement que vous avez choisi.
Le parcours
Un parcours reproductible, du modèle métier aux données exploitables
beVault applique la même approche pilotée par le modèle à chaque projet data. Définissez une fois le sens métier, connectez et historisez vos sources, vérifiez les données, publiez des résultats fiables et orchestrez les flux. Chaque étape s'appuie sur le même modèle et les mêmes métadonnées : vos équipes livrent de nouveaux cas d'usage sans repartir de zéro.
Build
Vos architectes décrivent les objets métier, leurs clés métier et leurs relations. C'est cette description qui pilote tout le reste.
Source
Les systèmes sources sont connectés et mappés sur le modèle, puis chargés en conservant l'historique de ce qui a été reçu.
Verify
Les contrôles de qualité s'appliquent aux données historisées et remontent les anomalies dans des listes exploitables.
Distribute
Les Information Marts sont produits dans la base cible, documentés et prêts pour la BI, les applications et les agents IA.
Orchestrate
L'orchestrateur intégré exécute les traitements, gère les dépendances et donne la visibilité sur chaque exécution.
Le point de départ
Data Vault comme fondation
Une fondation de données doit encaisser des sources qui changent, des définitions métier qui se précisent et des questions qu'on ne se pose pas encore. C'est ce que résout le Data Vault : chaque chargement est historisé, chaque clé métier est identifiée, rien n'est écrasé.
L'inconvénient est connu : écrit à la main, un Data Vault demande beaucoup de code répétitif et une discipline que peu d'équipes tiennent sur la durée. beVault prend en charge cette part mécanique et laisse à vos équipes la partie qui a de la valeur — le sens métier.
L'automatisation Data Vault en détailmetaVault
Le modèle métier avant le code
Dans metaVault, vos architectes décrivent ce que l'organisation manipule réellement : clés métier, relations, contextes, définitions. Ce modèle n'est pas un document d'accompagnement — c'est la source de vérité à partir de laquelle la plateforme travaille.
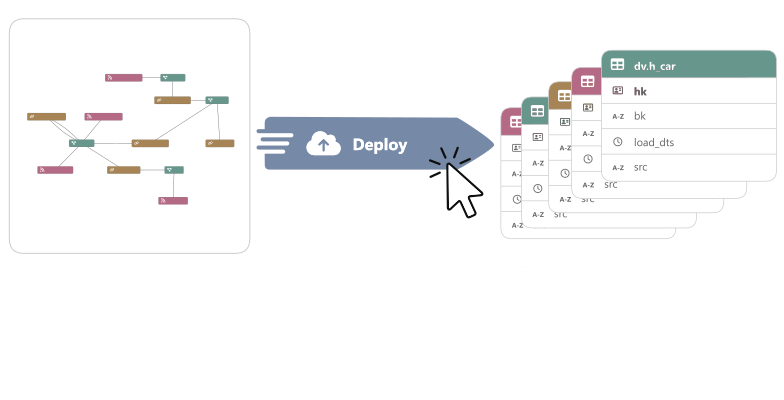
Voir la modélisation metaVaultParce que le modèle est stocké sous forme de métadonnées, la plateforme en dérive les structures, le code de chargement, la documentation et le lignage. Une modification du modèle se propage, au lieu de déclencher une campagne de reprise manuelle dans des dizaines de scripts.
Lignage et documentationIntégration
Préserver l'historique et le contexte des sources
Les données sont conservées telles qu'elles ont été reçues, sans écraser l'historique. Chaque chargement garde la trace de son origine et de sa date, ce qui permet de réutiliser le modèle brut pour de nouveaux besoins et de reconstruire une source telle qu'elle était à un instant donné. Vous disposez ainsi d'une base fiable pour l'analyse, l'audit et la conformité.
Intégration et connectivitéQualité et orchestration
Contrôler pendant, pas après
Les règles de qualité vivent dans la plateforme et s'appliquent au moment du chargement. Les écarts sont tracés, versionnés et attribuables à une source, plutôt que découverts un mois plus tard dans un tableau de bord.
Qualité des données et MDML'orchestration suit les dépendances du modèle : ordre d'exécution, parallélisme, reprises sur erreur et supervision. AWS Step Functions est pris en charge comme orchestrateur externe lorsque vous en utilisez déjà un.
OrchestrationInformation marts
Des données que le métier peut utiliser
Une fondation de données ne crée de la valeur que si les personnes et les systèmes peuvent l'utiliser. beVault publie des information marts gouvernés et des vues métier documentées pour le reporting, les applications, les API et les agents IA. Le même modèle peut servir aussi bien des requêtes analytiques précises que des expériences IA plus riches.
Information martsCes vues se consomment avec vos outils habituels — Power BI, Tableau, Looker ou tout client SQL — et par vos applications via l'API. Le serveur MCP permet également à des agents de dialoguer avec la plateforme.
API et agents IAEnvironnement cible
La plateforme s'installe chez vous
beVault ne remplace pas votre stack : il produit du code natif pour la base cible que vous avez déjà choisie, et s'exécute là où vous le décidez.
- Plateformes et bases cibles
- Snowflake, Amazon Redshift, Microsoft SQL Server et PostgreSQL sont supportés aujourd'hui. Databricks, Microsoft Fabric et Google BigQuery arrivent bientôt.
- Orchestrateur externe
- AWS Step Functions est pris en charge comme orchestrateur externe. Ce n'est pas une base cible : il déclenche et supervise les traitements.
- Déploiement
- Docker sert de technologie de déploiement des composants, sur site, en cloud ou en mode hybride, dans le périmètre que vous contrôlez.
Ce que cela change
Grandir sans reconstruire la fondation
Avec moins de code de chargement écrit à la main, des modèles cohérents et des information marts réutilisables, chaque nouveau cas d'usage devient plus simple à livrer. La fondation grandit avec votre organisation au lieu d'être remplacée chaque fois qu'une source, une définition métier ou un outil d'IA change.
Les résultats dépendent de votre point de départ : nombre de sources, état du modèle existant, maturité des équipes. C'est précisément ce que nous regardons ensemble lors d'une démonstration sur votre contexte.
Étape suivante